
ASUS Ascent GX10 im Praxistest: Lokale KI mit NVIDIA DGX Spark Technologie
Wie wir mit dem ASUS GX10 und Qwen 3.5 HR-Daten, Produktionskennzahlen und Verträge direkt im Büro mit KI verarbeiten. Der Mini-PC steht auf dem Schreibtisch, gerechnet wird auf seiner eigenen Hardware.
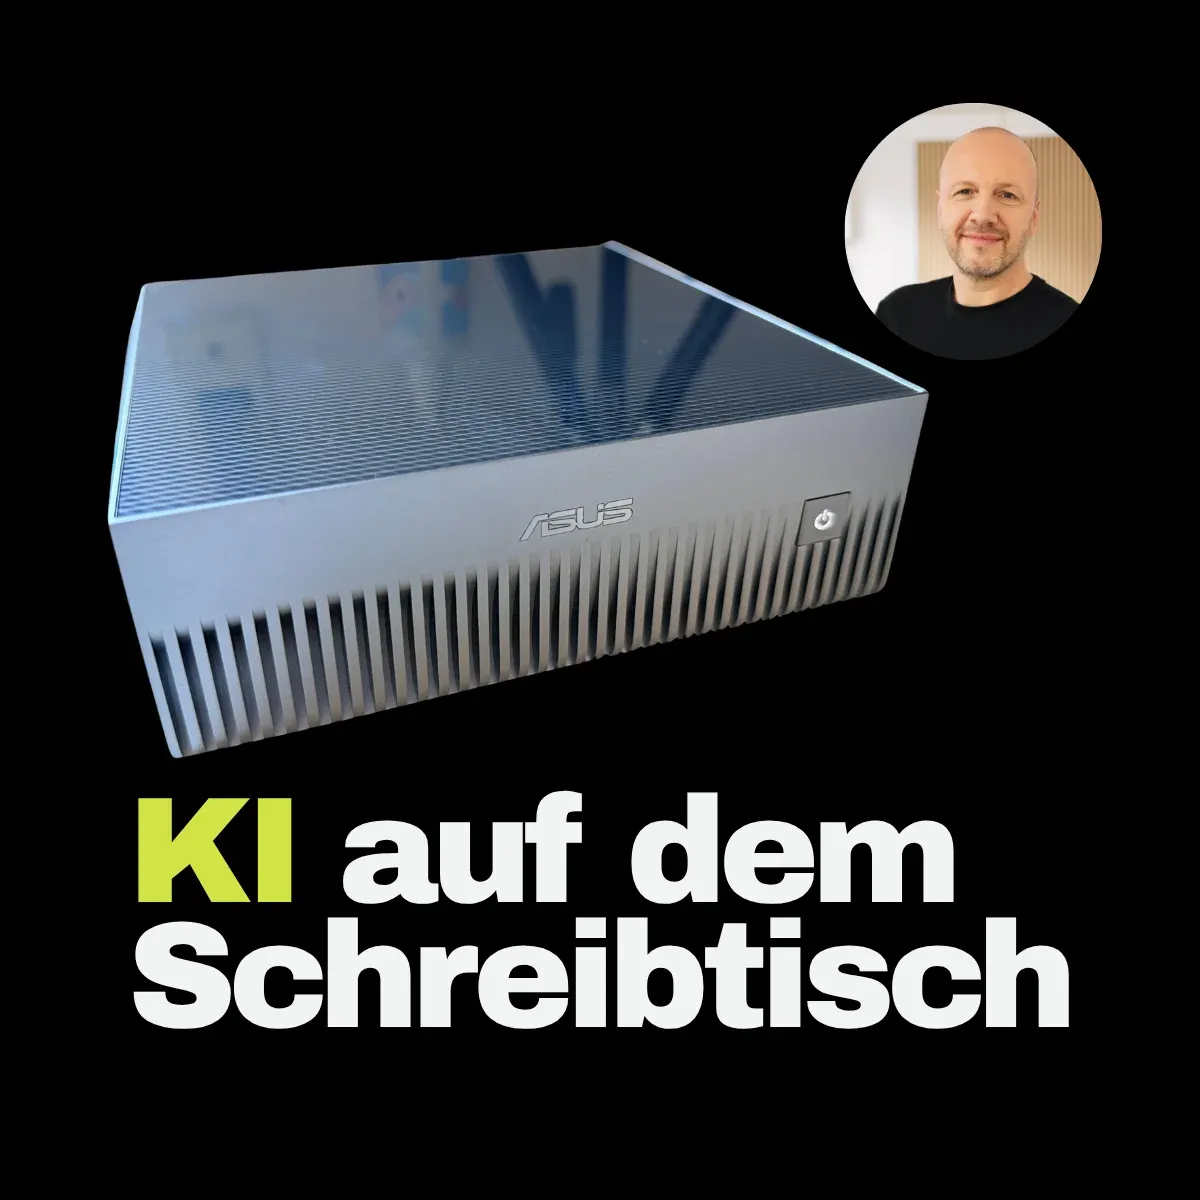
Bewerbungsunterlagen auswerten, Produktionskennzahlen analysieren, interne Berichte zusammenfassen. Dafür steht bei uns seit einigen Monaten ein Gerät von 15 mal 15 Zentimetern auf dem Schreibtisch, und die Daten verlassen dabei den Raum nicht.
Der ASUS Ascent GX10 läuft auf der NVIDIA-DGX-Spark-Plattform. Wir nutzen ihn täglich und haben nach mehreren Wochen im Dauerbetrieb ein Bild von Geschwindigkeit, Kosten und Grenzen.
KI, die im Unternehmen bleibt
Es gibt Unterlagen, bei denen die Frage nach dem Serverstandort jede Diskussion über KI beendet. Bewerbungen, Gehaltsabrechnungen, Produktionsrezepturen, Vertragsentwürfe. Auf einem Gerät wie dem GX10 werden genau diese Unterlagen verarbeitet, ohne dass jemand außerhalb sie sieht.
Im Personalbereich fasst das Modell Lebensläufe zusammen, wertet Mitarbeiterbefragungen aus und ordnet Zeugnisformulierungen ein. In der Produktion wertet es Qualitätsprotokolle aus, bereitet Schichtberichte auf und findet Abweichungen. In der Buchhaltung geht es um Quartalsberichte, Kalkulationen und Strategiepapiere, in der Rechtsabteilung um Vertragsentwürfe und die Vorbereitung von Prüfungen auf Regeltreue.
All das läuft auf dem Gerät selbst. Eine Internetverbindung braucht es dafür nicht. Wie sich dieser Weg gegen die Cloud rechnet, steht in Lokale KI vs. Cloud-KI.
Die Hardware
Der ASUS Ascent GX10 arbeitet mit dem NVIDIA GB10 Grace Blackwell, demselben Chip wie der NVIDIA DGX Spark. Die Geräte sind technisch baugleich, der GX10 kostet mit rund 3.800 € weniger als das Original von NVIDIA. Dell, Lenovo und MSI bauen ebenfalls Geräte mit diesem Chip, du bist also nicht auf einen Hersteller festgelegt.
| Merkmal | Wert |
|---|---|
| Chip | NVIDIA GB10 Grace Blackwell, DGX-Spark-Plattform |
| Arbeitsspeicher | 128 GB, gemeinsam für Hauptprozessor und Grafikeinheit |
| Speicher | 1 TB SSD |
| Stromverbrauch | rund 25 W im Leerlauf, rund 170 W unter Last |
| Größe | 15 mal 15 mal 5 cm |
| Preis | rund 3.800 € brutto in der 1-TB-Fassung |
Die 128 GB sind der Punkt, auf den es ankommt. Eine gewöhnliche Grafikkarte wie die RTX 4090 stellt einem Modell 24 GB zur Verfügung, der GB10 die vollen 128 GB, weil Prozessor und Grafikeinheit sich denselben Speicher teilen. Dadurch passt ein großes Modell vollständig hinein, und es bleibt Platz für Dokumente mit weit über 100 Seiten. Für Unternehmen, die regelmäßig mit langen Verträgen, Berichten und Protokollen arbeiten, ist das der eigentliche Gewinn.
Das Modell
Auf dem GX10 läuft Qwen 3.5 in der Fassung 35B-A3B unter Apache 2.0, also frei nutzbar. Das Modell hat 35 Milliarden Parameter und rechnet je Anfrage mit 3 Milliarden davon.
Möglich macht das die Bauform Mixture-of-Experts. Das Modell teilt seine Parameter in 256 Gruppen auf und schaltet je Anfrage nur die 8 ein, die zur Frage passen. Das Wissen bleibt vollständig erhalten, gerechnet wird mit einem Bruchteil, und genau deshalb läuft ein Modell dieser Größe auf dem GB10 flüssig.
Seit April 2026 gibt es mit Qwen 3.6 einen Nachfolger, der auf demselben Chip läuft. Einen Überblick über die aktuellen lokalen Modelle gibt Lokale LLMs im Vergleich. Die Messwerte hier stammen aus dem laufenden Einsatz mit Qwen 3.5.
Das Modell schreibt rund 55 Wörter pro Sekunde, also schneller, als du lesen kannst. Es liegt in 2 Fassungen vor, einer vollen mit 65 GB und einer verkleinerten mit 35 GB. Wir nehmen im Alltag die verkleinerte, sie ist schneller und der Qualitätsunterschied fällt bei unseren Aufgaben nicht auf.
Dazu kommt ein Denkmodus. Vor der Antwort arbeitet das Modell die Aufgabe innerlich durch, was bei verschachtelten Fragen die Qualität hebt und Zeit kostet. Für Zusammenfassungen schalten wir ihn ab, dann geht es noch einmal deutlich schneller.
Wofür wir das Gerät benutzen
Bei Bewerbungen und Personalunterlagen fasst das Modell Lebensläufe zusammen, wertet Fragebögen aus, ordnet Zeugnisformulierungen ein und bereitet Gesprächsleitfäden vor. Weil alles auf dem Gerät bleibt, dürfen dabei echte Personaldaten in die Eingabe.
In der Fertigung geht es um Ausschussquoten, Maschinenparameter, Qualitätskennzahlen und Rezepturen. Das Modell fasst Produktionsberichte zusammen, benennt Abweichungen, bereitet Schichtberichte auf und macht technische Dokumentation durchsuchbar.
Bei Verträgen, Strategiepapieren und Finanzanalysen zählt vor allem, dass nichts nach außen geht. Du gibst dem Modell ein Dokument mit 80 Seiten und lässt dir die 3 wichtigsten Punkte nennen. Möglich ist das durch das Kontextfenster von 262.144 Token, also rund 200 Seiten in einem Durchgang.
Was das Gerät nicht kann
Bilder erzeugen gehört nicht zu seinen Stärken, dafür gibt es andere Hardware. Die größten Cloud-Modelle liegen bei verschachtelten Denkaufgaben weiter vorn. Arbeiten mehrere Leute gleichzeitig damit, sinkt die Geschwindigkeit spürbar, für ein größeres Team kommt ein zweites Gerät dazu. Und Modelle trainieren lässt sich damit nicht, der Rechner ist für den Betrieb fertiger Modelle gebaut.
Ob diese Geräteklasse die richtige ist oder eine Workstation mit einer einzelnen Grafikkarte reicht, hängt an den Modellen und an der Zahl der Leute, die gleichzeitig arbeiten. Prüfe diese Anforderungen vor dem Kauf.
Warum llama.cpp und nicht Ollama
Wer sich mit lokaler KI beschäftigt, stößt schnell auf Ollama. Es ist der einfachste Weg, ein Modell zu starten, und wir empfehlen es regelmäßig für den Einstieg, siehe Ollama in Unternehmen.
Auf dem GX10 nehmen wir stattdessen llama.cpp direkt, also die Software, auf der Ollama selbst aufbaut. Die DGX-Spark-Hardware ist noch jung, und Anpassungen für den GB10-Chip landen zuerst dort. Bis sie in Ollama ankommen, vergehen Wochen bis Monate.
Auf gewöhnlicher Hardware und für den Einstieg bleibt Ollama die bessere Wahl. Der direkte Weg über llama.cpp lohnt sich dort, wo eine neue Chipgeneration im Spiel ist und jede Anpassung zuerst im Ursprungsprojekt erscheint.
Unsere Einrichtung im Detail
Dieser Abschnitt richtet sich an alle, die selbst einen ASUS GX10, einen NVIDIA DGX Spark oder ein anderes Gerät mit GB10-Chip haben.
Als Betriebssystem läuft DGX OS auf Ubuntu-Basis, angepasst für den GB10, dazu CUDA 13.0 mit Treiberversion 580.126.09. llama.cpp haben wir aus dem Quelltext gebaut, Stand Tag b8182 vom 28.02.2026.
| Modell | Fassung | Dateigröße |
|---|---|---|
| Qwen 3.5 35B-A3B | unverkleinert, BF16 | 65 GB |
| Qwen 3.5 35B-A3B | Q8_0 | 35 GB |
| Qwen3-Coder-30B-A3B | Q8_0 | 31 GB |
Alle 3 sind Mixture-of-Experts-Modelle mit 3 Milliarden aktiven Parametern und passen damit zum GB10.
Der llama-server läuft als systemd-Dienst und startet beim Hochfahren mit.
llama-server \
    -m ~/models/Qwen_Qwen3.5-35B-A3B-Q8_0.gguf \
    -ngl 999 \
    -c 262144 \
    -np 1 \
    --no-mmap \
    --jinja \
    -fa 1 \
    --host 0.0.0.0 \
    --port 8080
Dabei legt -ngl 999 alle Schichten auf die Grafikeinheit und nichts auf den Hauptprozessor, -c 262144 setzt das Kontextfenster auf 256K Token, -fa 1 schaltet Flash Attention für sparsameren Speicherverbrauch ein, --jinja sorgt für die richtige Formatierung der Anweisungen, und --host 0.0.0.0 macht den Server im lokalen Netz erreichbar.
Ein Shell-Skript namens switch-model.sh wechselt zwischen den 3 Modellen und stellt dabei Kontextgröße und Denkmodus ein. Es schreibt die Dienstdatei neu und startet den Server durch.
Warum wir Q8 statt BF16 fahren: Bei einem Mixture-of-Experts-Modell rechnen je Token nur 3 Milliarden Parameter. Q8 halbiert die Datenmenge, die dafür durch den Speicherbus muss, und das schlägt direkt auf die Token pro Sekunde durch. Der Qualitätsunterschied ist in Testreihen messbar, im Alltag fällt er nicht auf.
Was das Gerät leistet
3.800 € sind eine Anschaffung, und dafür steht ein Assistent im Haus, der ohne laufende Kosten arbeitet, jederzeit bereit ist und die Daten im Unternehmen behält. 55 Wörter pro Sekunde, ein Kontextfenster für über 200 Seiten, auf einem Gerät, das neben den Monitor passt.
Wer den einfacheren Weg auf vorhandener Hardware sucht, fängt bei Ollama in Unternehmen an. Welche Software daneben in Frage kommt, steht in KI-Tools im Überblick.