Wie ihr KI für eure Arbeit nutzt, Firmenwissen zugänglich macht und wiederkehrende Aufgaben automatisiert. Wir erklären Einsatzmöglichkeiten von KI anhand konkreter Aufgaben aus Unternehmen.
8 lokale Modelle sollten dasselbe fehlerhafte Programm reparieren. Der Beitrag vergleicht die Ergebnisse und zeigt, welche Änderungen sich durch Tests überprüfen ließen.
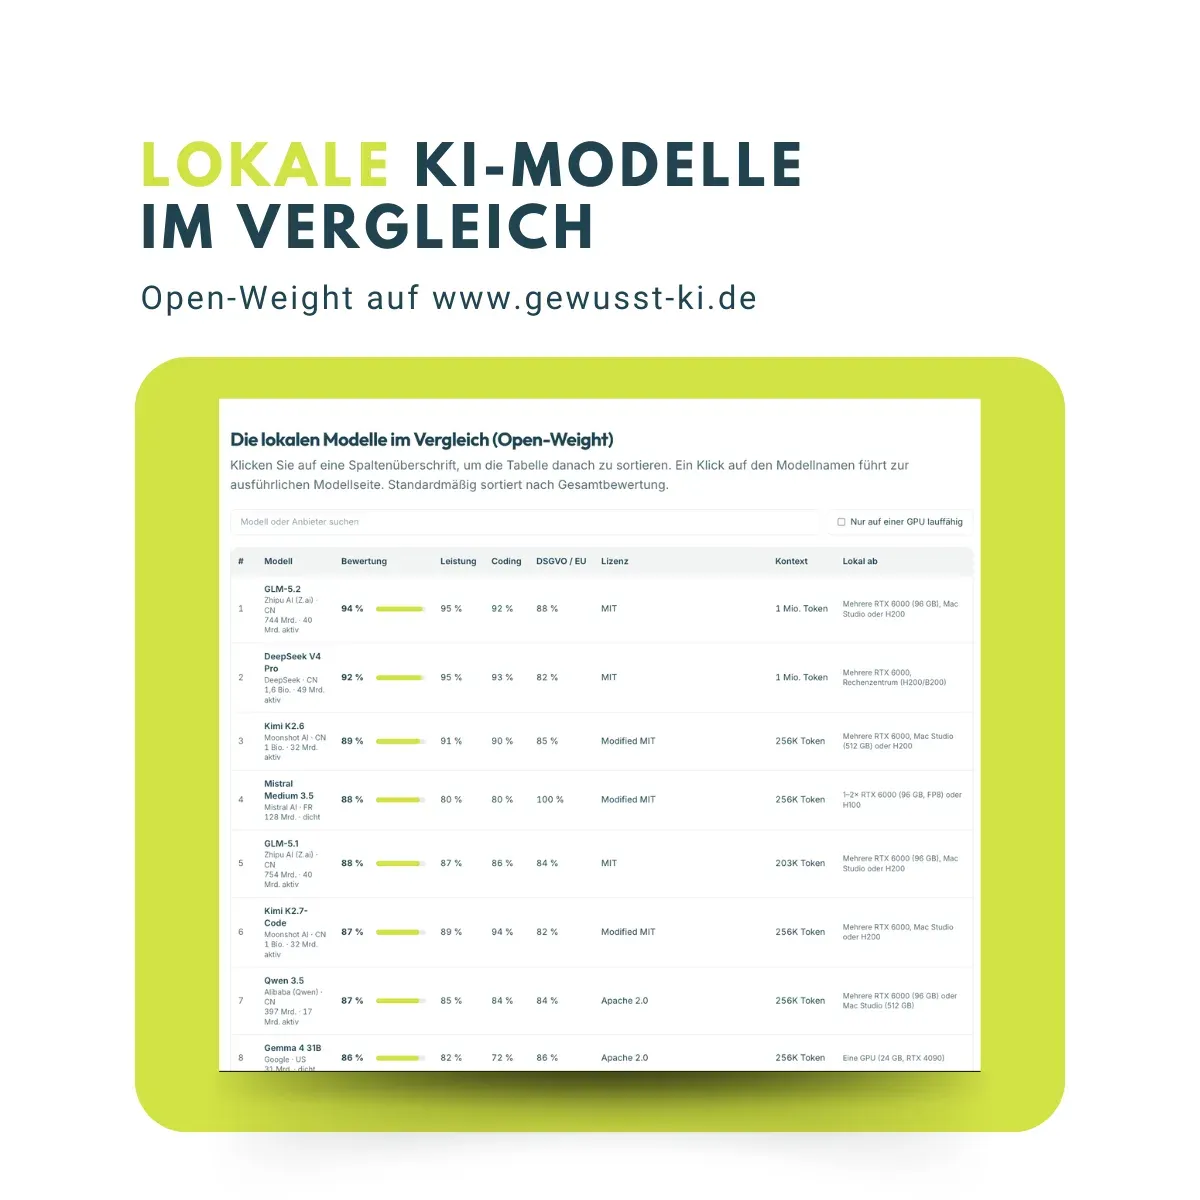
31 offene KI-Modelle in einer sortierbaren Tabelle, filterbar nach deinem Anwendungsfall. Wie du schnell das passende Modell findest und was für den Betrieb auf eigener Hardware spricht.
Ein kleines KI-Modell misst sich mit den großen Cloud-Systemen, weil es länger nachdenkt statt größer zu werden. Wir haben es auf eigener Hardware getestet.
Multi-Token Prediction und Block Diffusion verdoppeln die Geschwindigkeit lokaler Sprachmodelle, ohne dass neue Hardware fällig wird. Messwerte aus dem eigenen Test mit Qwen 3.6 und Gemma 4 auf dem Mac.
Google hat Anfang April 2026 Gemma 4 unter Apache 2.0 veröffentlicht, Alibaba 2 Wochen später Qwen 3.6 35B-A3B. Nach 2 Wochen Parallelbetrieb schreibt Gemma 4 das bessere Deutsch, Qwen 3.6 den besseren Code.
Bei lokaler KI rechnet das Sprachmodell auf einem Server im eigenen Unternehmen, und keine Eingabe geht nach draußen. Der Einstieg beginnt bei einem Arbeitsplatzrechner mit einer Grafikkarte ab 32 GB.
Qwen 3.6, Gemma 4, GPT-OSS und GLM laufen auf Hardware, die im Unternehmen steht, und kosten keine Lizenzgebühr. Austauschbar sind sie nicht, jedes der 4 hat eine Arbeit, bei der es die anderen schlägt.
Wie wir mit dem ASUS GX10 und Qwen 3.5 HR-Daten, Produktionskennzahlen und Verträge direkt im Büro mit KI verarbeiten. Der Mini-PC steht auf dem Schreibtisch, gerechnet wird auf seiner eigenen Hardware.
KI für eure Aufgaben einsetzen
Wir unterstützen euch bei der Auswahl und Einführung passender Anwendungen.