
Welches KI-Modell passt ins Unternehmen? Ein Vergleich offener Modelle
31 offene KI-Modelle in einer sortierbaren Tabelle, filterbar nach deinem Anwendungsfall. Wie du schnell das passende Modell findest und was für den Betrieb auf eigener Hardware spricht.
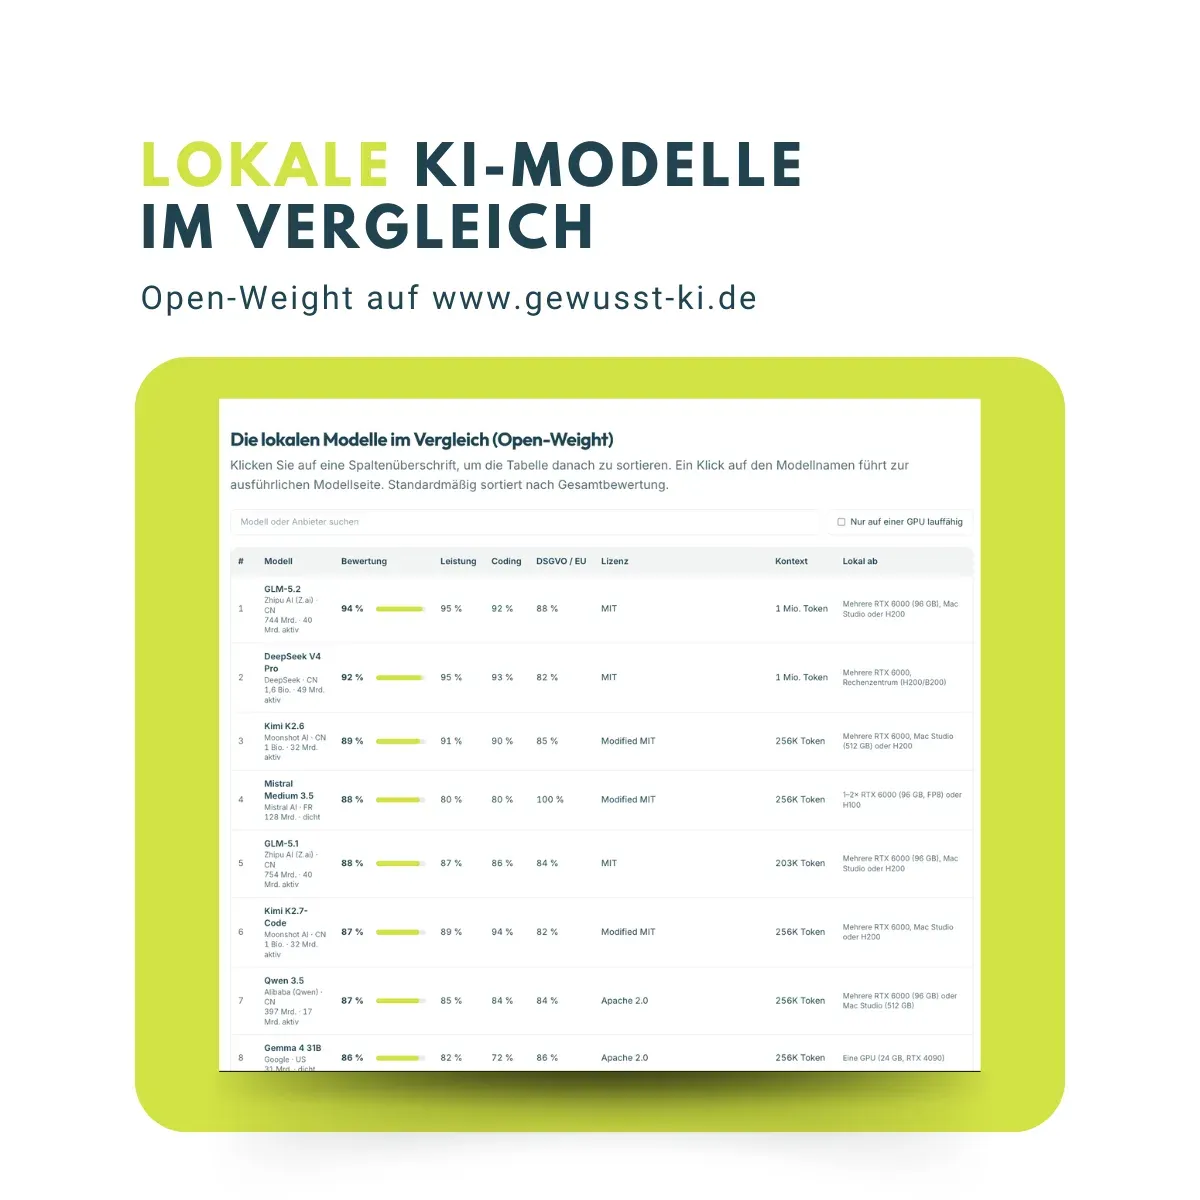
Welches KI-Modell passt zu deiner Aufgabe, zu deinen Daten und zu deiner Hardware? Auf der Seite /ki-modelle stehen 31 offene Modelle in einer sortierbaren Tabelle, die sich nach Leistung, Programmierung, Datenschutz-Eignung oder nötiger Hardware ordnen lässt. Alle davon lassen sich datenschutzkonform betreiben, auf eigener Hardware oder bei einem europäischen Hoster.
Ein Überblick, der aktuell bleibt
Vor 2 Jahren war lokale KI ein Kompromiss. Wer seine Daten nicht in eine US-Cloud geben wollte, bekam spürbar schwächere Antworten. Das hat sich gedreht. Mit GLM-5.2 spielt heute ein frei lizenziertes Modell vorne mit und hält bei Programmieraufgaben mit den teuersten kommerziellen Systemen mit.
Das Feld bewegt sich fast im Wochentakt. Allein im April und Juni 2026 sind mit GLM-5.2, Qwen 3.6, Gemma 4 und MiniMax M3 mehrere der stärksten offenen Modelle dazugekommen. Ein Blogbeitrag mit einer festen Empfehlung wäre nach 2 Wochen überholt. Deshalb steht dort eine Tabelle, die wir laufend nachziehen, und hinter jedem Modell eine eigene Seite mit den dokumentierten Messwerten und der Hardware, die es wirklich braucht.
Nach deinem Anwendungsfall filtern
Jede Spalte der Tabelle lässt sich per Klick sortieren, dazu gibt es ein Suchfeld und einen Filter für Modelle, die auf einer einzelnen Grafikkarte laufen.
| Deine Lage | Der Griff in die Tabelle |
|---|---|
| viel Programmierung | nach der Spalte Coding sortieren, oben stehen Kimi K2.7-Code und GLM-5.2 |
| nur eine Grafikkarte vorhanden | den Haken bei “Nur auf einer GPU lauffähig” setzen, übrig bleiben Qwen3.8-27B, Gemma 4 31B und gpt-oss-20b |
| strenge Datenschutz-Vorgabe | nach DSGVO und EU sortieren, oben stehen Mistral und gpt-oss-120b |
| lange Dokumente und Akten | auf die Kontext-Spalte achten, GLM-5.2 und DeepSeek V4 Pro nehmen ganze Vertragswerke am Stück |
| freie kommerzielle Nutzung | die Lizenz-Spalte prüfen, Apache 2.0 und MIT erlauben Einsatz, Anpassung und Weitergabe ohne Auflagen |
| keine eigene Hardware geplant | die Modelle mit EU-Verfügbarkeit nehmen und über einen europäischen Anbieter nutzen |
Aus der vollständigen Liste wird so in wenigen Klicks eine kurze Auswahl. Die Details, auf die es vor der Entscheidung ankommt, stehen dann auf der Seite des einzelnen Modells.
Warum dort nur offene Modelle stehen
ChatGPT und Gemini fehlen auf der Seite mit Absicht. Verglichen werden ausschließlich Modelle mit offenen Gewichten, deren Dateien du herunterladen und selbst betreiben kannst. Nur diese laufen im eigenen Unternehmen oder bei einem europäischen Hoster, ohne dass Daten an einen US-Anbieter gehen. Die großen Cloud-Dienste ordnen wir in der KI-Tools-Datenbank ein.
| Merkmal | Offenes Modell | Cloud-Schnittstelle |
|---|---|---|
| Ort der Verarbeitung | dein Server oder ein EU-Hoster | Rechenzentrum des Anbieters |
| Kontrolle über die Daten | vollständig | beim Anbieter |
| Modell austauschbar | jederzeit, gleiche Dateibasis | an den Anbieter gebunden |
| Kosten | Hardware oder Preis je Anfrage | Preis je Anfrage |
Ein offenes Modell verarbeitet deine Daten dort, wo du es betreibst. Auf einem Server im Unternehmen greift kein externer Anbieter darauf zu. Deshalb konzentrieren wir uns bei Datenschutzfragen auf diese Modellklasse.
Wie wir ein Modell bewerten
Die Prozentzahl neben jedem Modell ist unsere redaktionelle Einschätzung und keine amtliche Messung. Damit sie nachvollziehbar bleibt, liegt die Gewichtung offen.
Die Leistung zählt zu 55 %. Sie fasst die dokumentierten Messwerte für Programmierung, logisches Schließen und Wissen zusammen. Zur unabhängigen Orientierung gleichen wir das grob mit dem Arena-Elo von arena.ai ab, übernehmen es aber nicht eins zu eins.
Die DSGVO- und EU-Eignung zählt zu 30 %. Dahinter steht die Frage, ob sich das Modell ohne Datenabfluss in ein Drittland betreiben lässt. Lokal erfüllt das jedes offene Modell, zusätzlich zählen die belegte Verfügbarkeit bei europäischen Hostern und die Herkunft des Anbieters.
Die Lizenz-Offenheit zählt zu 15 %. Apache 2.0 und MIT erlauben kommerzielle Nutzung, Anpassung und Weitergabe ohne Auflagen. Lizenzen mit Umsatzklauseln oder Pflicht zur Namensnennung werten wir niedriger.
Den Hardware-Aufwand halten wir bewusst aus der Note heraus und führen ihn als eigene Spalte. Ein Modell, das ein Rechenzentrum braucht, ist nicht schlechter als eines für eine einzelne Karte, es passt zu einem anderen Budget. Deshalb lässt sich die Tabelle auch nach “Lokal ab” sortieren.
Das Fähigkeitsprofil aus 6 Bereichen
Eine Gesamtnote sagt, wie gut ein Modell in den Unternehmenseinsatz passt. Sie sagt nicht, worin es besonders stark ist. Ein Modell mit hervorragenden Werten beim Programmieren kann bei langen Dokumenten schwächeln, ein Allrounder bei Mathematik. Deshalb steht daneben ein Profil über 6 Bereiche.
Beim Programmieren geht es darum, Code zu schreiben, Fehler darin zu finden und ganze Projekte über viele Schritte zu bearbeiten. Bei Mathematik und Logik um mehrstufiges Rechnen und Schließen mit prüfbarem Ergebnis. Beim Wissen um Fach- und Allgemeinwissen über viele Gebiete. Bei Deutsch und Sprache um Sprachverständnis und Mehrsprachigkeit, mit Blick auf das Deutsche. Bei Agentik und Werkzeugen darum, Programme selbständig aufzurufen und mehrstufige Abläufe zu steuern. Und beim langen Kontext darum, wie viel Leistung über sehr lange Eingaben tatsächlich nutzbar bleibt, jenseits der reinen Fenstergröße.
Bei der Herkunft der Messwerte sind wir ehrlich. Für die meisten Modelle stammen sie vom Hersteller selbst, eine unabhängige Prüfung liegt oft nicht vor. Nur für einzelne wie gpt-oss oder Kimi K2.6 gibt es eine unabhängige Einordnung durch Artificial Analysis, und auf jeder Modellseite steht, was zutrifft. Für eine belastbare Entscheidung ersetzt keine Tabelle den eigenen Test am eigenen Anwendungsfall.
Herkunft ist nicht der Datenschutz-Faktor
Die stärksten offenen Modelle stammen derzeit aus chinesischen Laboren, von DeepSeek, Moonshot, Zhipu, Alibaba und MiniMax. In unseren Gesprächen löst schon das Wort China ein Zögern aus. Datenschutzrechtlich zählt aber der Ort der Verarbeitung, nicht das Herkunftsland des Modells.
Ein offenes Modell aus China ist keine Datenschutzfrage, solange du es auf eigener Hardware oder bei einem europäischen Hoster betreibst. Dann bleibt die Verarbeitung in deiner Infrastruktur. Kritisch ist allein die öffentliche Cloud-Schnittstelle der Anbieter, weil dabei Daten über chinesische Server laufen. GLM-5.2 läuft bereits bei Scaleway in Frankreich, Kimi K2.6 bei Nebius in den Niederlanden, beide innerhalb der EU.
Wer auch den Anbieter unabhängig machen will, findet mit Mistral aus Frankreich das stärkste Modell aus europäischer Hand. Bei reinen Programmieraufgaben liegt es hinter den chinesischen Spitzenmodellen, dafür bleibt die gesamte Lieferkette in Europa.
Was für den Betrieb auf eigener Hardware spricht, und was dagegen
Lokal betreiben heißt, das Modell läuft auf deiner eigenen Hardware, im Serverraum oder auf einer Workstation. Das ist die strengste Form der Kontrolle über die eigenen Daten, und umsonst ist sie nicht.
Dafür spricht, dass die Verarbeitung vollständig im Unternehmen bleibt, ohne Verbindung zu einem Cloud-Anbieter. Bei dauerhaft hoher Nutzung rechnet es sich zusätzlich, weil keine Kosten je Anfrage anfallen. Und du bleibst unabhängig von Preisänderungen, eingestellten Modellen und geänderten Nutzungsbedingungen.
Dagegen spricht, dass die Hardware vorab kostet und gewartet werden will. Die stärksten Modelle brauchen mehrere Workstation-Karten oder einen Mac Studio mit viel Speicher, dazu jemanden, der die Einrichtung übernimmt. Bei geringer oder schwankender Nutzung stehen teure Karten die meiste Zeit still.
Für den Einstieg eignen sich Modelle, die auf einer einzelnen Grafikkarte laufen. Qwen3.8-27B passt auf eine Karte mit 24 GB und übertrifft beim Programmieren deutlich größere Vorgänger. Wer mehr braucht, plant eine RTX PRO 6000 mit 96 GB ein, für die größten Modelle mehrere davon. Karten aus dem Rechenzentrum wie H100 oder B200 sind nur nötig, wenn sehr viele Anfragen gleichzeitig anfallen.
Der zweite Weg für alle ohne eigene Hardware
Selbst betreiben ist nicht der einzige datenschutzkonforme Weg. Dieselben offenen Modelle laufen auch bei Anbietern in der EU, etwa IONOS in Deutschland, OVHcloud und Scaleway in Frankreich oder Nebius in den Niederlanden. Du zahlst je Anfrage und brauchst keine eigene Hardware.
Am breitesten verfügbar ist gpt-oss-120b, das offene Modell von OpenAI, das bei allen 4 genannten Anbietern läuft. Die Auswahl wächst, hinkt bei den neuesten Modellen aber hinterher, deshalb lohnt vor der Entscheidung ein Blick in den Katalog des jeweiligen Anbieters. Welcher der beiden Wege passt, hängt an Datenmenge, Nutzung und dem Wissen, das im Unternehmen vorhanden ist.
Die Vergleichsseite ziehen wir nach, wenn neue Modelle erscheinen oder sich die Messlage verschiebt. Sie ist die Momentaufnahme eines Feldes, das sich schnell bewegt, und der Ausgangspunkt für die Frage, mit der fast jedes Projekt beginnt. Einen geführten Einstieg gibt der Workshop zu lokaler KI.