
Eigenes KI-Modell trainieren: Was es wirklich kostet
Ein Sprachmodell von Grund auf zu trainieren kostet dreistellige Millionenbeträge. Für fast jede Aufgabe im Unternehmen reichen die 3 Stufen davor, und die kosten zwischen nichts und ein paar tausend Euro.
OpenAI hat für einen Trainingsdurchlauf von GPT-5 rund 460 Millionen Euro ausgegeben und steckt jährlich über 8 Milliarden Euro allein in Rechenleistung für Forschung und Entwicklung. Wenn ein Unternehmen fragt, ob es nicht einfach eine eigene KI trainieren könne, hängt die Antwort daran, was mit dem Wort gemeint ist.
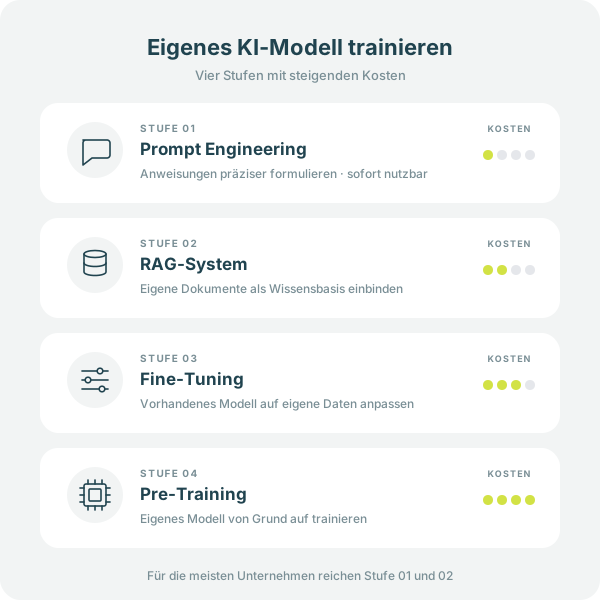
Vier verschiedene Vorgänge laufen unter “KI trainieren”, und sie unterscheiden sich im Preis um den Faktor einer Million. Nur der letzte davon ist tatsächlich das, was OpenAI mit seinen 460 Millionen macht. Für fast jede Aufgabe im Unternehmen reichen die 3 Stufen darunter.
Stufe 1: bessere Anweisungen, ohne Projekt
Du sagst der KI, was sie tun soll, und zwar so genau, dass sie es trifft. Dafür braucht es kein Training, keine Programmierung und kein Budget. Wer die Rolle, das Format und die Grenzen nennt, bekommt ein anderes Ergebnis als wer nur die Frage stellt. Im Fach heißt das Prompt Engineering.
Statt “Schreib mir eine E-Mail” also besser: “Du bist ein erfahrener Vertriebsmitarbeiter eines Maschinenbauunternehmens. Schreibe eine freundliche, aber professionelle Antwort auf eine Kundenanfrage zum Liefertermin. Der Ton soll auf eine Lösung zulaufen und sich nicht entschuldigen.”
Die zweite Anweisung nennt die Rolle, den Ton und das Ziel. Damit fällt der Entwurf so aus, dass man ihn überarbeiten kann, statt ihn wegzuwerfen.
Der Weg lohnt sich für alle, die sofort anfangen wollen, für Aufgaben ohne firmeneigenes Wissen und für die Frage, ob KI hier überhaupt etwas bringt. Seine Grenze ist schnell erreicht: Die KI kennt deine Preisliste nicht und weiß nicht, was in deinem Wartungshandbuch steht.
Stufe 2: RAG, die KI liest in euren Dokumenten mit
RAG heißt ausgeschrieben Retrieval Augmented Generation. Statt die KI mit dem Firmenwissen zu trainieren, bekommt sie Lesezugriff auf die Dokumente. Kommt eine Frage, sucht sie zuerst in den Unterlagen und schreibt die Antwort aus dem, was sie dort findet, mit Angabe der Fundstelle.
Dauerhaft lernt die KI dabei nichts. Deine Daten landen nicht im Modell, sie werden bei jeder Frage neu nachgeschlagen. Das hat 3 Folgen im Alltag. Ändern sich Preise oder Abläufe, tauschst du das Dokument aus und die Antwort stimmt ab der nächsten Frage. Die Daten bleiben auf deinem Server, kein Cloud-Anbieter sieht sie. Und die KI kann die Fundstelle nennen, also Handbuch und Seitenzahl, womit sich jede Antwort nachprüfen lässt.
Die technische Tiefe steht im Artikel Wie du der KI dein Firmenwissen beibringst, den Weg zur Umsetzung beschreibt der Praxisguide: RAG-System aufsetzen.
RAG passt für Unternehmen, die schon Handbücher, Sammlungen häufiger Fragen und Richtlinien haben, bei denen Datenschutz zählt und deren Wissen sich regelmäßig ändert.
| Bereich | Was in den Bestand kommt |
|---|---|
| Produktion und Industrie | Wartungshandbücher, Sicherheitsvorschriften und Bedienungsanleitungen, abrufbar ohne seitenlanges Suchen |
| Dienstleistung und Beratung | Angebots- und Vertragsvorlagen, interne Prozessbeschreibungen, Rückmeldungen von Kunden |
| Kanzlei und Gesundheitswesen | Gesetze, Abrechnungsregeln und interne Leitlinien, verarbeitet auf einem Rechner im Unternehmen |
Stufe 3: Fine-Tuning, das Modell selbst weitertrainieren
Beim Fine-Tuning nimmst du ein fertiges Sprachmodell wie Gemma, Qwen oder Mistral und trainierst es mit eigenen Beispieldaten nach. Das Modell verändert dabei seine Gewichte und übernimmt einen Schreibstil, eine Fachsprache oder ein bestimmtes Verhalten. Sein allgemeines Können verliert es dadurch nicht.
Der Weg lohnt sich, wenn die KI einen festen Stil oder einen Fachjargon beherrschen soll, wenn tausende gleichartige Aufgaben anfallen, etwa das Einsortieren von Supportanfragen, und wenn bessere Anweisungen und RAG vorher nicht gereicht haben.
Was es kostet, hängt am Weg. Über eine Cloud-Programmierschnittstelle geht es kaum noch: OpenAI fährt die eigene Fine-Tuning-Plattform herunter und lässt keine neuen Nutzer mehr zu. Wer schon Zugang hat, zahlt für gpt-4.1 rund 21,60 Euro je Million Trainings-Token, umgerechnet aus 25 US-Dollar.
Für alle anderen führt der Weg über offene Modelle. Ein Modell mit 8 Milliarden Parametern, also ein Qwen oder Gemma dieser Größe, kostet mit LoRA zwischen 900 und 2.800 Euro an gemieteter Rechenzeit. Eine eigene RTX 5090 kostet einmalig 4.290 Euro. Bei 2 Trainingsläufen im Monat zu je 8 Stunden auf einer gemieteten H100 für 2,80 Euro die Stunde stehen dem 45 Euro monatlich gegenüber, die Karte hätte sich also erst nach rund 8 Jahren bezahlt. Sie lohnt sich, wenn dieselbe Karte daneben auch den täglichen Betrieb übernimmt.
Drei Dinge machen dabei Arbeit. Du brauchst hunderte bis tausende gute Beispiele, und schlechte Beispiele bringen ein schlechtes Modell hervor, weshalb der Artikel Warum die beste KI an deiner Ablage scheitert an dieser Stelle mitgelesen gehört. Das Wissen steht danach auf dem Stand des Trainings, und bei geänderten Abläufen wird neu trainiert. Und selbst mit LoRA oder QLoRA braucht der Durchlauf eine ordentliche Grafikkarte.
LoRA und QLoRA sind die Verfahren, die Fine-Tuning für kleine Unternehmen überhaupt erreichbar machen. Statt alle Milliarden Parameter neu zu trainieren, was Wochen dauert und über 100 GB Grafikspeicher braucht, trainiert LoRA nur einen Bruchteil davon, typischerweise unter 1 %. Der Speicherbedarf sinkt damit auf 16 bis 24 GB. QLoRA verkleinert das Modell zusätzlich und kommt auf 8 bis 12 GB. Beide erreichen in der Praxis 90 bis 95 % der Qualität eines vollständigen Durchlaufs.
Vier Fehler sehen wir dabei immer wieder. Unter 500 guten Beispielen bringt Fine-Tuning meistens nichts, und mehr schlechte ersetzen die fehlenden guten nicht. Widersprechen sich die Beispiele untereinander, lernt das Modell die Widersprüche mit. Viele greifen zum Fine-Tuning, wo RAG einfacher und billiger gewesen wäre. Und ohne eine Testmenge, die im Training nicht vorkam, sieht niemand, ob das Modell besser geworden ist oder sich nur an die Trainingsdaten erinnert.
RAG oder Fine-Tuning, wann was
Flüchtiges Wissen gehört in RAG, stabiles Verhalten ins Fine-Tuning. Liefert die KI falsche Fakten, also veraltete Preise oder den falschen Ansprechpartner, löst RAG das. Findet sie die richtigen Angaben, gibt sie aber im falschen Ton oder Format aus, hilft Fine-Tuning.
Für die allermeisten Anwendungen im Unternehmen ist RAG der bessere Anfang, weil es billiger ist, sich schneller ändern lässt und sofort mit dem aktuellen Stand arbeitet.
Stufe 4: Pre-Training, hunderte Millionen Euro
Ein Sprachmodell von Grund auf zu bauen ist das, was die meisten meinen, wenn sie “KI trainieren” sagen. Die veröffentlichten Zahlen dazu:
| Modell | Trainingskosten |
|---|---|
| GPT-4 (2023) | über 92 Millionen Euro |
| GPT-5 (2025) | rund 460 Millionen Euro je Durchlauf |
| Gemini Ultra von Google | geschätzt bis zu 175 Millionen Euro |
| Nächste Generation | voraussichtlich über 1 Milliarde Euro je Modell |
Das sind die reinen Rechenkosten. Dazu kommen die Beschaffung und Bereinigung der Daten, die Gehälter der Spezialisten, die Infrastruktur und der Strom.
Beim Pre-Training liest das Modell Milliarden von Texten, Büchern und Artikeln und lernt daraus Grammatik, Fakten und Zusammenhänge. Heraus kommt ein rohes Sprachmodell, das Sätze vervollständigen kann, aber weder Fragen beantwortet noch Anweisungen befolgt. Der nützliche Teil entsteht erst danach.
Kaum ein Unternehmen geht diesen Weg, und dafür gibt es 4 Gründe. Die Kosten liegen im dreistelligen Millionenbereich. Es dauert Monate bis Jahre. Du konkurrierst dabei mit offenen Modellen, die nichts kosten. Und am Ende hast du die Grundlage, nicht die Anpassung an dein Unternehmen.
Ein Grund, es trotzdem zu tun, wäre eine Sprache oder ein Fachgebiet, das in den vorhandenen Modellen nicht vorkommt. Für deutsche Geschäftsdokumente trifft das nicht zu.
Welche Methode für welchen Zweck
| Methode | Bis zum ersten Einsatz | Wofür |
|---|---|---|
| Bessere Anweisungen | sofort, ohne Projekt | Einstieg, allgemeine Aufgaben, erste Versuche |
| RAG | 2 bis 4 Wochen | Wissensmanagement, Anfragen, Dokumentation |
| Fine-Tuning | 4 bis 8 Wochen, dazu geprüfte Trainingsdaten | fester Schreibstil, Einsortieren von Dokumenten |
| Pre-Training | Monate bis Jahre, hunderte Millionen Euro | große Technologiekonzerne, Forschungsinstitute |
Lokal oder Cloud, wo die Modelle laufen
Genauso oft wie nach dem Training werden wir gefragt, ob die Daten dafür in die Cloud müssen. Für gute Anweisungen und für RAG nicht. Beides läuft mit Modellen, die im eigenen Unternehmen stehen. Zum Ausprobieren nimmst du Ollama auf einer Arbeitsstation mit genug Grafikspeicher. Für den Dauerbetrieb mit mehreren Nutzern gehört ein Server mit vLLM dahinter, einer Software, die ein Modell für viele Anfragen gleichzeitig bereithält.
Wer für das Fine-Tuning Rechenzeit mieten will, zahlt derzeit zwischen 1,80 und 3,70 Euro die Stunde für eine NVIDIA H100 mit 80 GB. Eine NVIDIA A100 gibt es ab 1,20 Euro die Stunde. Für ein Modell mit 7 Milliarden Parametern reicht mit LoRA oft eine einzelne Karte für wenige Stunden.
Als Oberfläche für die Mitarbeiter eignet sich AnythingLLM. Es verbindet sich mit den eigenen Dokumenten und bringt eine Chat-Oberfläche mit, für die niemand programmieren muss. Wer Abläufe automatisieren will, ohne Code zu schreiben, findet in n8n oder Langflow den Einstieg.
Bevor du Geld in Fine-Tuning oder ein teures Cloud-Abo steckst, richte eine lokale RAG-Lösung mit deinen 20 wichtigsten Dokumenten ein. In unseren Projekten deckt das den größten Teil dessen ab, was das Unternehmen ursprünglich vom Training erwartet hat, zu einem Bruchteil der Kosten. Welche Plattform dafür passt, zeigt der Vergleich Ollama, LM Studio und GPT4All.
Die 4 Fragen, die wir vorher stellen
Bevor wir mit einem Unternehmen über Methoden sprechen, klären wir dasselbe wie immer.
- Was soll die KI tun? Eine KI, die Supportanfragen einordnet, braucht andere Methoden als eine, die Angebote im Firmenstil formuliert.
- Welche Daten liegen vor? Handbücher und PDF-Dateien reichen für RAG. Fine-Tuning verlangt tausende geprüfte Paare aus Eingabe und gewünschter Ausgabe, und wer die nicht hat, kann nicht trainieren.
- Wie oft ändern sich die Abläufe? Bei häufigen Änderungen gewinnt RAG, weil ein neues Dokument genügt. Fine-Tuning braucht jedes Mal einen neuen Durchlauf.
- Was darf die KI überhaupt sehen? Bei Kundendaten, Betriebsgeheimnissen oder medizinischen Angaben führt der Weg über eine Lösung im eigenen Unternehmen.
Meistens zeigt schon die zweite Frage, dass die Idee vom eigenen Training das eigentliche Problem gar nicht gelöst hätte.
Womit du anfängst
Fang mit besseren Anweisungen an, sie kosten nur Zeit. Reicht das nicht, weil Firmenwissen dazugehört, nimm RAG. Erst danach steht Fine-Tuning zur Debatte. Kommt RAG dazu, läuft es auf eurer eigenen Hardware, und die Dokumente bleiben dabei im Unternehmen. Wie ein solcher Aufbau aussieht, steht im Beitrag zu Ollama im Unternehmen. Bei der KI-Strategie dahinter helfen wir.
Ehrlicherweise gehört dazu, dass auch die billigste Stufe Arbeit macht. Gute Anweisungen kosten kein Geld, aber jemand muss sie schreiben, ausprobieren und im Team weitergeben, und genau daran ist in unseren Projekten schon mehr gescheitert als an fehlender Rechenleistung.